本記事にはアフィリエイト広告(PR)が含まれます。詳しくは広告掲載ポリシーをご覧ください。
AI(ローカルLLM)が答えを出すとき、中では「読む」と「書く」という2つの仕事が順番に走っています。この記事は、その2つの仕事に分けて、AIがどのように動いているのか、そして速さと大きさが何で決まるのかを、各社の公表値から説明するものです。
2026年8月25日に発表された新しい Mac Studio は、最大512GBのユニファイドメモリを積みます。出荷は9月22日、512GB構成は10月下旬。実機のレビューはまだ世に出ていません。そこで当サイトは、Apple をはじめ各社が公表した数値だけを使い、「どのサイズの言語モデルまで、どれくらいの速さで動くのか」を計算で出しました。
結論:Mac Studio M3 Ultra 512GB が向く人・向かない人
向く人
- 400B級の大きなモデルを、1台で動かしたい方
- 長い資料を読ませる方(読み込みの実測は 480 tok/s・70B 4bit)
- 速度より「載るかどうか」を優先する方
- 電力と設置スペースを抑えて、長時間動かしたい方
向かない人
- 70B以下しか動かさず、短いやり取りが中心の方(より安い選択肢が複数あります)
- 生成速度を最優先する方(同じメモリ量でも、理論上より速い機材があります)
- 512GB構成を組みたい方(カスタマイズ注文からになります)
AIの速さを決めるのは、帯域と演算性能の2つです
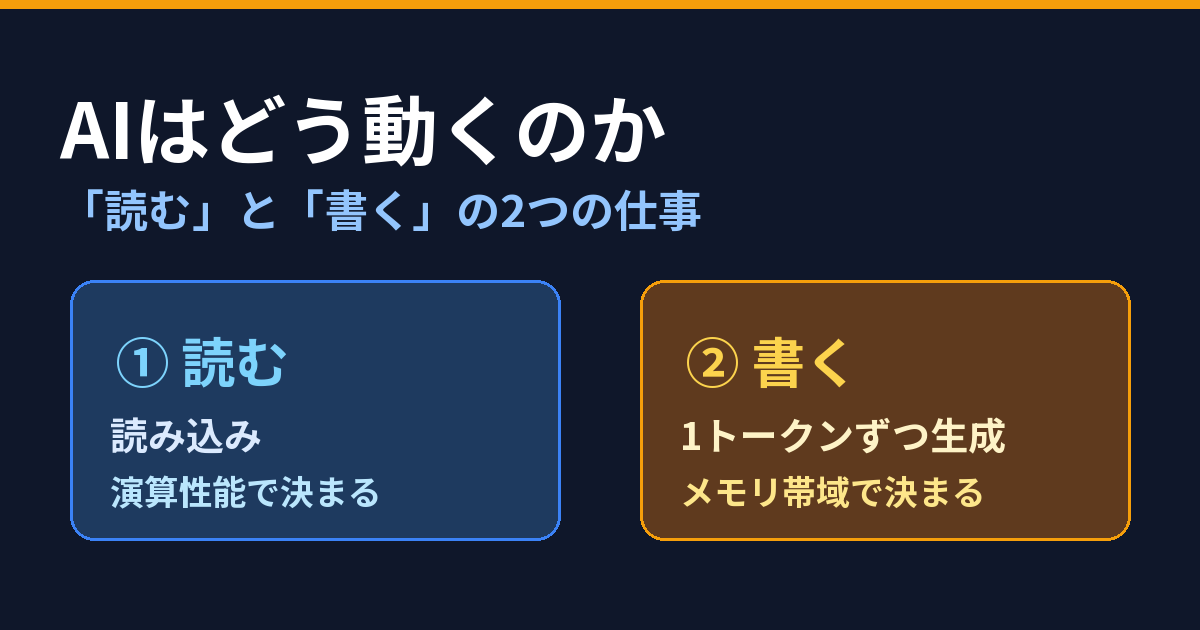
言語モデルを手元で動かすとき、カタログの演算性能(TFLOPS や TOPS)だけを見ても、速さは決まりません。かといって、メモリ帯域だけでも決まりません。仕事によって、効く数字が入れ替わります。どの仕事がどちらで決まるのか。次の図1がその対応表です。読み込み(段階1と2)は演算性能、書く(段階3)はメモリ帯域。
図1 の左がメモリ、中央が帯域、右が GPU です。メモリは物を置いておく場所、GPU は計算する場所。計算するには、置いてあるものを帯域を通って GPU へ運ばなければなりません。
メモリに置いてあるのは2つです。読ませる資料と、モデルの重み42GB。重みは AI が学習で覚えた数字の集まりで、AI の中身そのものです。読ませる資料のことではありません。
読み込み(段階1と2)では、重み42GBを1回運べば済みます。運んだ重みを、読ませる資料ぜんぶに使い回しながら、GPU がまとめて総当たりで調べます。ところが書く(段階3)では、1文字出すたびに重み42GBを丸ごと運び直します。同じ荷物を、1文字ごとに何度も運び直しているのが書くほうです。
なお本記事では、読み込みを ①、書くを ② と呼びます。以降の ①② はこの意味です。読み込みでは重みは1回、書くでは1文字ごとに丸ごと——この違いが、本記事の土台です。
その「運ぶ速さ」がメモリ帯域です。正確には、メモリと GPU のあいだで1秒間に受け渡せるデータ量のことです。単位は GB/s。メモリの種類と、つなぐ道の本数で決まります。この記事で「配管の太さ」と呼んでいるのは、これのことです。
⚠ メモリ容量とは別物です。容量は「どれだけ入るか」(GB)、帯域は「1秒にどれだけ動かせるか」(GB/s)。倉庫が大きくても、配管が細ければ遅い——この違いは後ほど効いてきます。
まず読む、そのあと書く。読み込みの中身は2段階です
図1の3つの段階を、順番に詳しく見ていきます。
- 段階1 まず読む 仕事A:重みと資料をメモリからGPUへ運び、語を重みに通す。語が増えても重みを読む回数は1回のまま
- 段階2 GPUの中で総当たり:重みを使わず、GPU内だけで語と語の関係を調べる。語の数の2乗で増える
- 段階3 そのあと書く:1トークンずつ出す。1文字ごとに重みと作業メモを取りに行く
このうち段階3だけがメモリ帯域の仕事です。段階1と2を合わせた読み込み(プロンプト処理)は、入力が十分に長いとき演算性能で決まります。律速が入れ替わる理由は、この後の節で1つずつ説明します。
同じ質問でも、読み込み(①)と書く(②)のどちらに時間がかかるかは、渡す資料の長さと、求める答えの長さのバランスで変わります。
たとえば200ページの報告書を渡して「要点を3行でまとめて」と頼む場合。読み込む語数は数万語あるので、総当たりの計算(段階2)に何秒もかかります。いっぽう答えは3行だけなので、書く(段階3)の時間はわずかです。待ち時間のほとんどが①の読み込みになります。ここを速くするには、GPUの演算性能が効きます。
逆に「3行の指示から企画書を書いて」と頼む場合、読み込むのは3行だけですから、①は一瞬で終わります。答えが数ページに及ぶので、1文字出すたびに重み42GBと作業メモを取りに行く②の運搬が、出す文字数ぶん繰り返されます。待ち時間のほとんどが②の書くになります。ここを速くするには、メモリ帯域が効きます。
つまり「長い資料を短く要約する」なら演算性能、「短い指示を長く書かせる」ならメモリ帯域。どちらの使い方が中心かで、選ぶべき機材の強みが変わります。
なお本記事は1人で1つずつ使う前提です。何人分もまとめて処理する使い方では、演算性能の比重が上がります。
①に時間がかかるのは、総当たりだから
読むといっても、上から順に目で追うわけではありません。どの語がどの語と関係しているかを、総当たりで調べます。
語が4つなら、組み合わせは4×4で16通り。8つなら8×8で64通りです。語の数が2倍になると、調べる量は4倍になります。
だから長い資料ほど、不利さの増え方が急です。2倍の長さの資料を渡すと、待ち時間は2倍では済みません。
この総当たりは、そのまま計算の量です。運ぶ量ではなく、調べる量が問題になっているわけです。この総当たりがどれだけの時間を食うのかは、次の節で見ていきます。
そして①が終わるまで、②は始まりません。長い資料を渡したときの「何も出てこない時間」は、この総当たりに使われています。
⚠ 実際には、総当たりを一部省く工夫が入っています。待ち時間がちょうど4倍になるわけではありません。ただし長くなるほど不利という性質は残ります。
①のなかでは、2種類の計算が走っています
重みと資料、メモリと GPU の関係を整理します。①では、性質の違う2つの計算が走っています。
図のとおり、登場するのは3つの役です。それぞれ何をしているかを分けて説明します。
メモリ(置く場所):モデルの重み42GBと、読ませる資料4,096語を置いておく場所です。計算の本体ではありません。置いてあるものを、必要なときにGPUへ渡します。
帯域(運ぶ速さ):メモリとGPUをつなぐ配管です。①では、重み42GBを1回だけ運べば足りません。正確には「1回の読み出しを4,096語で共用する」ので、重みを読む回数は語数が増えても1回のままです。資料の運搬は語数に比例して増えますが(100万語なら約8GB)、重み42GBに比べればずっと小さくて済みます。
GPU(計算する場所):運ばれてきた重みと資料で、2種類の計算を走らせます。
- 仕事A:語を重みに通す。資料の語を42GBの重みに通します。語の数に比例して増え、4,096語なら4,096語ぶんです。
- 仕事B:語どうしの総当たり。こちらは重みを使いません。語と語を突き合わせるだけです。語の数の2乗で増え、4,096語なら4,096×4,096で約1,677万通りになります。GPUの中だけで完結する計算です。
これが「①は演算性能で決まる」の中身です。重みを読む回数は1回のままなので、語数が増えても重みの読み出し時間(帯域の仕事)は増えません。増えるのはGPUのなかでの計算(仕事Aは比例・仕事Bは2乗)だけ。だから長い資料ほど、待っているのは運搬ではなく計算であり、①は演算性能で決まります。
そして長い資料で効いてくるのは仕事Bです。前の節で「総当たり」と呼んでいたのは、この仕事Bのことでした。
| 4語のとき | 8語のとき | 増え方 | |
|---|---|---|---|
| 仕事A(重みに通す) | 4語ぶん | 8語ぶん | 2倍 |
| 仕事B(総当たり) | 16通り | 64通り | 4倍 |
⚠ 資料が大きくなれば、待ち時間は長くなります。ただし、運ぶ量が増えるからではありません。資料の文字は、重み42GBに比べればごく小さいままです。長くなる原因は、GPU がする計算が増えることです。
運ぶバイト数も2倍にはなりますが、元が小さいので42GB に対しては誤差です。このほかに作業メモ(KVキャッシュ)も2倍になり、こちらはメモリの容量を食います。
つまり資料を2倍にすると、運ぶ量はほとんど変わらないのに計算だけが2倍・4倍に増えます。だから待ち時間は2倍では済みません。①が演算性能で決まる、というのはこの意味です。
①でも、重みを運ぶ作業は起きています。42GBの重みをメモリから GPU へ運ぶことは、①でも②でも変わりません。
違うのは、1トークンあたりに割り当てられる運搬量です。
| 1回に運ぶ量 | 何トークン分に使うか | 1トークンあたり | |
|---|---|---|---|
| ② 生成 | 42GB | 1トークン | 42GB |
| ① 読み込み(4,096トークン) | 42GB | 4,096トークン | 約10MB |
1トークンあたりの運搬量が、4,096分の1に薄まります。いっぽう1トークンあたりの計算量は、①でも②でも変わりません。
運搬だけが薄まって、計算はそのまま。だから比率がひっくり返り、計算のほうが先に足りなくなります。配管が太くなったのではなく、同じ配管で運んだ荷物を、何千回も使い回しているから余裕が生まれています。
短い指示のときは、①も帯域で決まります
ここまでは、長い資料を渡す前提の話でした。条件が変われば、①でも帯域が効きます。プロンプトが短いと、使い回しが効かないからです。極端な話、1トークンだけのプロンプトの①は、②の1回とまったく同じになります。運搬42GB、計算1回ぶん。
「①は演算性能で決まる」は、入力が十分に長いときの話です。短い指示を投げるときは、①も帯域で決まります。
②に時間がかかるのは、1トークンごとに全部読み直すから
②の文章生成では、1つの単語を出すたびに、モデルの重みをメモリから読み出します。70Bのモデルを4bitに圧縮すると約42GB。つまり1トークンごとに42GBを読む計算です。
速度を決めるのは「1秒に何回計算できるか」ではなく、「1秒に何GB読めるか」。だから生成速度は、演算性能ではなくメモリ帯域でほぼ決まります。式にすると単純です。
- 理論生成速度(tok/s)= メモリ帯域(GB/s)÷ モデルの実効サイズ(GB)
819GB/s の機材で42GBのモデルなら、819 ÷ 42 で約19.5。この割り算が、本記事の土台です。
🔑 ②で「全部読む」のは、dense モデルだけです
ここが本記事でいちばん間違えやすいところです。モデルには2つの型があります。
| 型 | 毎回読む量 | 例 |
|---|---|---|
| dense(密) | 重みの全部 | 従来型 |
| MoE(専門家混合) | 一部の専門家だけ | 近年増えている型 |
MoE は「総パラメータ数」と「毎回使うパラメータ数(活性)」が別です。すると容量と速度で、見るべき数字が変わります。
- 載るかどうか … 総パラメータ数で決まる(全部メモリに置く必要がある)
- どれくらい速いか … 活性パラメータ数で決まる(毎回読むのはこれだけ)
たとえば総400B・活性40B の MoE を4bitで動かす場合、こうなります。
| 必要メモリ | 毎回読む量 | 819GB/s での理論速度 | |
|---|---|---|---|
| dense 400B | 約240GB | 約240GB | 約 3.4 tok/s |
| MoE 総400B・活性40B | 約240GB | 約24GB | 約 34 tok/s |
同じ400Bでも10倍違います。
🔑 そしてこれは、大容量マシンの価値を押し上げます。MoE は「容量は要るが、帯域はそこまで要らない」型です。512GBという容量が生きるのは、まさにこの型。本記事の以降の数値は、断りのない限り dense を前提にしています。
量子化で、②の必要メモリが変わる
モデルは重みの精度を落として容量を減らせます。これが量子化です。目安は次のとおりです。
| 精度 | 1Bあたり | 70Bでの必要量 | 位置づけ |
|---|---|---|---|
| 16bit | 約2.0GB | 約140GB | 元の精度に近い |
| 8bit | 約1.0GB | 約70GB | 品質の低下は小さいとされる |
| 4bit | 約0.6GB | 約42GB | 手元で動かす際の標準的な選択 |
本記事の数値はすべて4bitです。8bitにすると必要量はおよそ1.7倍になり、載るモデルの上限も速度もその分下がります。「何Bまで動くか」の答えは、量子化の前提を書かないと意味を持ちません。
GPUは、待っている時間のほうが長い
先に、2つの言葉を分けておきます。演算性能は GPU の能力です。1秒に何回計算できるかを指します。メモリ帯域は GPU の能力ではありません。メモリと GPU を結ぶ経路の太さで、1秒に何バイト運べるかを指します。
なお本記事の演算性能は、行列の掛け算の速さに限った話です。ゲームの描画性能ではありません。AI の計算はほとんどが行列の掛け算のため、各社ともそこ専用の回路を積んでいます。
GPU の中には、計算する回路と、重みを置いておくメモリがあります。速いのは計算する側です。メモリから重みが届くのを、計算する回路が待っている。生成中に起きているのは、これです。
⚠ 帯域は読み書き両方の速さですが、この用途では読むほうが圧倒的に多くなります。モデルの重みは読むだけで、書き換えることはありません。書き込まれるのは作業メモ(KVキャッシュ)だけで、読む量に比べれば桁が小さい。だから本記事の式は、読む量だけで計算しています。
どれくらい待っているのか。本記事に出てきた数字だけで見積もれます。
一般に、1トークン分の計算量はパラメータ数のおよそ2倍とされます。70Bなら約1,400億回です。M3 Ultra の理論速度19.5 tok/s をかけると、毎秒およそ2.7兆回になります。
いっぽう運ぶ量は毎秒819GB、つまり毎秒0.8兆バイトです。両方を並べると、1バイト運ぶあいだに、計算はおよそ3回しか行われていないことになります。
演算器はこれよりずっと多くを処理できます。だから生成中は、GPU の大部分が空いたまま待つことになります。帯域を増やすと速くなり、演算性能を増やしても変わらないのは、このためです。
読む側では、これが逆転します。同じ重みを何千トークン分にもまとめて使うため、1バイトあたりの計算回数が桁違いに増えます。運搬が追いつき、こんどは計算が間に合わなくなる。ここで初めて演算性能が効いてきます。
実際に走る順番に並べると、こうなります(図5)。
ここは取り違えやすいところです。メモリが GPU より遅いから詰まるのではありません。メモリの速さも GPU の速さも、①と②で変わっていません。変わったのは仕事の中身です。運ぶ量のわりに計算が少ないから、②では運搬のほうが先に尽きます。
この違いは対策にも効いてきます。「メモリが遅い」のなら、速い機械を買うしかありません。「仕事の中身」なら、やり方を変える手が残ります。後述の⑥が、まさにそれにあたります。
⚠ 上の見積もりは概算です。1トークンあたりの計算量はモデルの構造によって変わり、実際の帯域も理論値どおりには出ません。桁の感覚をつかむためのものとしてご覧ください。
①は、帯域では測れません
読む側の速さは、帯域からは計算できません。この部分について、Apple 自身が数値を公開しています。
M5 の GPU には、行列積を専門に扱う回路が載りました。Neural Accelerators と呼ばれるものです。以下は Apple が MLX を使って測定した、M4 との比較値です。
| 項目 | M4 → M5 |
|---|---|
| メモリ帯域(120→153GB/s) | 1.28倍 |
| 行列積の速度 | 4倍 |
| 最初の1トークンまでの時間 | 最大4倍速 |
| 2トークン目以降の生成 | 1.19〜1.27倍 |
下の2行に、ここまでの話がそのまま出ています。2トークン目以降の伸び(1.19〜1.27倍)は、帯域の伸び(1.28倍)とほぼ一致します。一方で最初の1トークンまでの時間は、帯域が28%しか増えていないのに最大4倍まで縮んでいます。
到達点も公開されています。14B の dense モデルで最初の1トークンまで10秒未満、30B の MoE モデルで3秒未満とされています。
⚠ これは M5 の基本モデル(153GB/s)の値であり、M3 Ultra の値ではありません。Apple は M3 Ultra での同種の数値を公表していません。読み込みの世代差を含めた比較では、M5 世代のほうが有利です。本記事の比較表は帯域だけで並べているため、長い文書を読ませる使い方での世代差は、表より大きくなる可能性があります。
このあとの「3機種の速度比較・何B が動くか・注意点・FAQ」は、記事を分けています。機種の選び方・速度の比較は、姉妹記事をご覧ください。
- 【比較編】Mac Studio M3 Ultra vs DGX Spark vs RTX 5090|ローカルAIの速度を公表値から計算する
- 【価格・新製品編】新型Mac mini(M6)とMac Studio(M5 Max/M5 Ultra)の全構成と価格|ローカルAIの速度を公表値から計算する — 発売された M5・M6 の AI 速度を M3 Ultra との比較で示す
本記事で紹介した機材(Amazon)
本記事で取り上げた機材です。価格と在庫は Amazon でご確認ください(Amazonアソシエイト・リンクにはアフィリエイトタグが含まれます)。
- Apple Mac Studio(M5 Maxチップ・18コアCPU/32コアGPU) — メモリ128GB/256GB/512GB は商品ページ内で選択できます

コメント