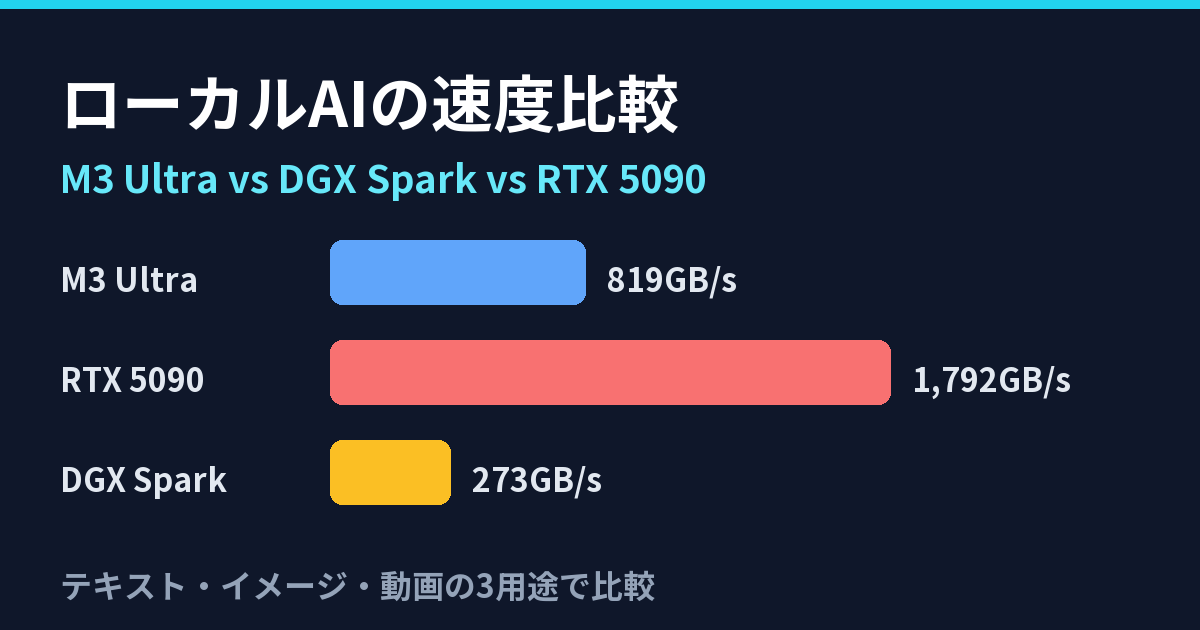
本記事は、Mac Studio M3 Ultra 512GB・NVIDIA DGX Spark・RTX 5090 の3機種を、ローカルLLM(70Bクラス)・画像生成・動画生成の3つの用途で速度比較したものです。数値はすべて公表値と実測値からの計算に基づいています。
なお、AIがなぜ「読む」と「書く」で速さの決まり方が違うのか、という仕組みの解説は姉妹記事にまとめています。仕組みから知りたい方は、まず下の記事をご覧ください。
また、新型 Mac mini(M6)・Mac Studio(M5 Max/M5 Ultra)の全構成・価格と、発売された M5・M6 の AI 速度を M3 Ultra と比べた記事は、【価格・新製品編】にまとめています。
【仕組みの解説】AIはどう動くのか|「読む」と「書く」の2つの仕事・速度を決めるメモリ帯域の仕組み
基本情報:3機種で70Bはどれくらいの速さで動くのか(コンテキスト別)
ここでは読者の検討対象として、Mac Studio M3 Ultra・NVIDIA DGX Spark・RTX 5090 の3機種に絞って基本情報を並べます。基準となるモデルは 70B(4bit量子化で約42GB)。さらに、扱う資料の長さを「短い(4千語=会話1回分)」「中(13万語=本1冊分)」「長い(100万語=小説150冊分)」の3つに決めて、それぞれの速度を計算しました。
3機種の基本情報
| Mac Studio M3 Ultra | DGX Spark | RTX 5090 | |
|---|---|---|---|
| AI演算(FP4) | 公表なし | 1,000 TOPS | 3,352 TOPS |
| メモリ帯域 | 819GB/s | 273GB/s | 1,792GB/s |
| メモリ容量 | 最大512GB(統一メモリ) | 128GB(統一メモリ) | 32GB GDDR7(GPU専用) |
| CUDA | なし(Metal/MLX) | あり | あり |
| 電力 | 約250W(静音) | 240W | 575W(要PC全体) |
出典は Apple・NVIDIA の公式技術仕様と、各社が公表したベンチマークです。
70B(4bit・42GB)はどの機種に載るか
- M3 Ultra(最大512GB):載る。最大512GBまで拡張可能で、100万語コンテキストでも42GB+KV 320GB=約362GB が入る
- DGX Spark(128GB):載る。1台で70B 4bit(42GB)+KV 40GB +余白でぎりぎり収まる
- RTX 5090(32GB VRAM):載らない。70B 4bit は42GB で VRAM 32GB を超えるため、比較対象から除外
3つのコンテキスト別の生成速度(tok/s)
生成(段階3)は、1トークン出すたびに重み42GBとその時点までの作業メモ(KV)を読むため、コンテキストが長いほど速さが落ちます。次の表は、3機種の帯域と実効率0.68から計算した70Bの生成速度です。
| 機種 | 短い(4千語) | 中(13万語) | 長い(100万語) |
|---|---|---|---|
| M3 Ultra(819GB/s) | 12.9 tok/s | 6.8 tok/s | 1.5 tok/s |
| DGX Spark(273GB/s) | 4.3 tok/s | 2.3 tok/s | 0.5 tok/s |
| RTX 5090(1,792GB/s) | 70B が載らないため測定不能 | ||
※ 読み込み(段階1と2)については、M3 Ultra が70Bで毎秒480トークンの実測あり。DGX Spark は8Bで毎秒10,256トークンの公表値から70B相当を換算すると毎秒約1,170トークンです。RTX 5090 は70Bを扱えないため比較対象外です。
まとめ:70Bを動かすなら、3つのコンテキストどれを選んでも M3 Ultra が最も速く、DGX Spark はその3分の1の速度。RTX 5090 は帯域こそ最速ですが、70B を載せるメモリ容量が足りず、比較対象になりません。
3大カテゴリー別の速度比較:テキスト・イメージ・動画
AIの速さは、扱う内容によって律速が変わります。テキストを書く仕事(LLM)、イメージを1枚生み出す仕事(画像生成)、イメージを360枚連続で生み出す仕事(動画生成)——この3大カテゴリーでは、勝つ機材が異なります。
カテゴリーと律速の一覧
| カテゴリー | 入力 → 出力 | 律速 | 代表モデル |
|---|---|---|---|
| A テキスト系 | テキスト → テキスト | メモリ帯域 | GLM-5.3-Flash・DeepSeek-V4 |
| B イメージ系 | テキスト → イメージ(1枚) | 演算性能(FLOPS) | Stable Diffusion・Flux |
| C 動画系 | テキスト → 動画(イメージの連続+音声) | 演算性能+メモリ容量 | MiniMax H3・Seedance 2.5(APIのみ) |
3機種別の実測・推定速度
A テキスト系:LLM 70B(4bit・42GB)4千語コンテキストでの生成速度
| 機種 | 生成速度 | 備考 |
|---|---|---|
| M3 Ultra(819GB/s) | 12.9 tok/s | 帯域律速・70B可 |
| DGX Spark(273GB/s) | 4.3 tok/s | 帯域が3分の1 |
| RTX 5090(32GB VRAM) | 測定不能 | 70Bが載らない |
B イメージ系:Stable Diffusion XL(1024×1024)1枚生成
| 機種 | 生成時間 | 備考 |
|---|---|---|
| RTX 5090 | 約3.5秒/枚 | FLOPS 3,352 TOPS |
| DGX Spark | 約11.7秒/枚 | FLOPS 1,000 TOPS |
| M3 Ultra | 約87.6秒/枚 | 実効約134 TOPS(近似) |
C 動画系:MiniMax H3 pruned版(15秒動画・768p)
| 機種 | 生成時間 | 備考 |
|---|---|---|
| RTX 5090 | 約560秒(約9分) | VRAM 32GB で pruned 版ギリギリ |
| DGX Spark | 約1,877秒(約31分) | VRAM 128GB で余裕あり |
| M3 Ultra | 約14,008秒(約3.9時間) | VRAM 512GB で余裕最大・ただし FLOPS が足りない |
※ イメージ・動画生成の速度は、各機種の FLOPS 比(RTX 5090 を基準)から推定した近似値です。実際の速度は、使用するソフト(ComfyUI・MLX 等)の最適化度合いによって変わります。M3 Ultra の TOPS は Apple が公表していないため、読み実測からの近似値を使用しています。
用途別の結論
テキスト生成には M3 Ultra。帯域が速く、大モデルが載り、静音・省電力です。
イメージ生成・動画生成には RTX 5090。FLOPS が圧倒的に大きく、CG系のAIでは最速です。ただし大モデルのメモリ容量が足りず、電力も575WとPC全体の設計が必要です。
両方を1台で回したい場合は、M3 Ultra と RTX 5090 PC の併用が理想ですが、コストは約320万円(M3 Ultra 512GB 約282万円+RTX 5090 PC 約35万円)に達します。予算に応じて、テキスト生成中心なら M3 Ultra、CG生成中心なら RTX 5090 PC、という使い分けが現実的な選択になります。
何B のモデルが動くのか
もう1つの式で、載るかどうかが決まります。
- 動かせる最大サイズ(B)= 実効メモリ(GB)÷ 0.6 ※4bit量子化
実効メモリという不確かさ
ユニファイドメモリの全量をGPUが使えるわけではありません。Appleはこの比率を公表していません。本記事では約75%と仮定します。
参考として、AMD は Ryzen AI Max+ 395 について「128GBのうち最大96GBをVRAMに変換できる」と明記しています。比率にすると0.75で、偶然ながら本記事の仮定と一致します。ただしAppleの値が同じである保証はありません。設定によって変わる可能性もあります。
この仮定のもとで、512GB構成の実効メモリは約384GBです。
| モデル(4bit) | 必要メモリ | 512GB構成での理論速度 |
|---|---|---|
| 70B | 約42GB | 約19.5 tok/s |
| 405B | 約243GB | 約3.4 tok/s |
| 上限 | 約384GB | 約640B まで |
⚠ 上限には、文脈のぶんが入っていません
上の「約640Bまで」はモデルの重みだけの計算です。実際には、会話や文書の内容を保持するKVキャッシュが別にメモリを使います。
文脈が長くなるほど増え、条件によっては数GB〜数十GBに達します。長い文書を扱うほど、載せられるモデルの上限は下がります。上の数字は「文脈が短いときの上限」と読んでください。
影響するのは容量だけではありません。KVキャッシュは、1トークン出すたびに読み直されます。文脈が長くなるほど、1トークンあたりに運ぶ量が増えていきます。
具体的な数字で見てみます。最大1Mトークン(約104万語)を扱える GLM-5.3-Flash(320B・FP8)を、512GB の Mac Studio M3 Ultra に載せる場合です。重みが328GB、OSや作業領域の余白が20GBを占めるため、KVに使えるのは約112GB。1Mトークン分の KV は約44GB なので、FP16 のままで計算上は約269万トークンまで積めます。これは公式上限の 1M の2.7倍にあたります。512GB 構成なら、1M は余裕を持って載る設計ということが分かります。
ただし速度は別の話です。GLM-5.3-Flash は MoE のため、1トークンの生成で読むのは重み全体ではなく活性 18B 分(約18.5GB)と KV です。コンテキストが伸びるほど KV が厚くなり、131k で毎秒34トークン前後だった生成が、1M では毎秒13トークン前後に落ちる計算です。1M の資料を渡したときにいちばん時間がかかるのは、生成ではなく読み込みの総当たりのほうです。
本記事の式には、文脈の長さが入っていません。短いやり取りでは目安になりますが、数万トークンを入れた状態では、実測がこの値より落ちます。
いずれも計算値です。実際の帯域は理論値の6〜8割に落ちるのが一般的です。メモリコントローラの効率や、読み出しの並び方によって差が出ます。実機での数値はまだ確認できていません。
長すぎる資料を渡すと、どうなるのか
壁は3つあります。たいていは1つ目で止まります。
| 何が起きるか | |
|---|---|
| 壁1 モデルの上限 | エラーになるか、黙って切り捨てられる |
| 壁2 作業メモ | KVキャッシュがメモリを食い尽くす |
| 壁3 物理メモリ超過 | SSD へ退避して、待てない遅さになる |
壁1 は、メモリの問題ではありません。モデルには「一度に受け取れる語数の上限」が設計として決まっています。8,000語・32,000語・100万語など、モデルごとに違います。これを超えたら、メモリがいくらあっても受け付けません。
⚠ 問題は黙って切り捨てられる場合です。渡したつもりの資料が読まれていないのに、AI は普通に答えます。読んでいない部分について、それらしい答えが返ってきます。長い資料を渡すときは、全部読まれたかを疑ってください。
壁2 は、上限の範囲内でも起きます。ここで大事なのは、溢れるのは資料そのものではないことです。資料の文字はごく小さい。溢れるのは、処理の途中で作られる作業メモ(KVキャッシュ)のほうです。ただしこの「資料の文字は小さい」も、長さによっては保てなくなります。資料本体の大きさは語数にほぼ比例し、100万語なら約8GB。重み42GB の2割に達するため、長い文書では「資料はごく小さい」とは言い切れなくなります。
壁3 は、Mac では落ちるのではなく遅くなります。物理メモリを超えると SSD へ退避するためです。SSD はメモリより桁違いに遅いので、動いてはいるが待てない速さになります。固まったように見えて、実は動いている状態です。
なお①の計算そのものは、資料を数百語ずつに区切って順番に処理できます。それでも足りなくなるのは、作業メモを全部持ち続けなければならないからです。計算は分けられても、結果は捨てられません。
ですから実務では、長すぎる資料を丸ごと渡しません。分割して要約させ、その要約をまとめて渡します。あるいは質問に関係する部分だけを探して渡します。「全部渡す」を諦めるのが答えになります。
同じメモリ量でも、速度は7倍変わります
70B(4bit・約42GB)が載る機材を、同じ物差しで並べます。
| 機材 | 実効メモリ | 帯域 | 理論速度 |
|---|---|---|---|
| RTX PRO 6000(96GB) | 96GB | 1,792GB/s | 約42.7 tok/s |
| Mac Studio M3 Ultra 512GB | 384GB | 819GB/s | 約19.5 tok/s |
| MacBook Pro M4 Max 128GB | 96GB | 546GB/s | 約13.0 tok/s |
| NVIDIA DGX Spark(128GB) | 非公開 | 273GB/s | 約6.5 tok/s |
| RTX 5090(32GB) | 32GB | 1,792GB/s | 70Bは載りません |
| RTX 4090(24GB) | 24GB | 非公開 | 70Bは載りません |
| Ryzen AI Max+ 395 128GB | 96GB | 256GB/s | 約6.1 tok/s |
実効メモリが同じ96GBの3機種でも、理論速度は約6.1〜42.7と7倍前後の開きがあります。「載るかどうか」と「どれくらい速いか」は別の話、というのがこの表の要点です。ここは目的によって選ぶものが変わるところです。
なお RTX PRO 6000 には Workstation版と Server版があり、帯域は1,792GB/sと1,600GB/sで異なります。同じ名前でも中身が違う点はご注意ください。
表の下2行に注目してください。RTX 5090 の帯域は1,792GB/sで、この表の最上位である RTX PRO 6000 と同じです。それでも70Bは動きません。VRAM が32GBで、必要な約42GBに届かないためです。
RTX 4090 は24GBで、さらに足りません。なお NVIDIA は RTX 40系の帯域を GB/s で公開していないため、この欄は空けています。
速さの前に、載るかどうかが効きます。帯域が表の最速でも、容量で脱落することがあります。ユニファイドメモリの Mac が大きなモデルで選ばれるのは、ここが理由です。
AI専用機が、いちばん速いとは限りません
表の中で目を引くのが DGX Spark です。NVIDIA が AI 向けに設計した机上機で、演算性能は FP4・スパースありで最大1 PFLOPと公表されています。演算の数字だけ見れば、この表で最も高い部類です。
それでも 70B の生成速度は、表の下から2番目にとどまります。帯域が273GB/s だからです。MacBook Pro M4 Max の546GB/s の半分、M3 Ultra の819GB/s の3分の1にあたります。
演算性能が高いことと、文章生成が速いことは別の話です。DGX Spark は、それが最もはっきり出る例になっています。大きなモデルを載せて開発する用途と、速く書かせる用途とでは、見るべき数字が違います。
なお DGX Spark の実効メモリは空欄にしています。GPU が使える割合を NVIDIA が文書化していないためです。総量は128GBなので、70B(約42GB)は載ります。
読ませると、順位が入れ替わります
ここまでの表は、すべて②生成の速さでした。①読み込みで並べ直すと、話が変わります。
NVIDIA は DGX Spark の実測値を公開しています。Llama 3.1 8B(NVFP4)で、①読み込みが毎秒10,256トークン、②生成が毎秒38.65トークンです。
同じ機械、同じモデルで265倍の開きがあります。演算性能が1 PFLOP ある機材は①で圧倒的に速く、②では帯域273GB/sに縛られる。本記事で説明してきた2つの仕事の違いが、1台の中にそのまま出ています。
Mac 側はどうか。Apple の公表値では、M5(基本モデル・24GB)が 14B の dense モデルで、プロンプト4,096トークンから最初の1トークンまで10秒未満。毎秒に直すと410トークン以上になります。
同じ Qwen3 14B で、DGX Spark は毎秒5,929トークンです。読ませる速さには、10倍以上の開きがあります。②の表で下から2番目だった機材が、①では前に出ます。
⚠ 測定条件は揃っていません。プロンプト長(4,096と2,048)、ソフトウェア(MLX と NVIDIA のスタック)、量子化の方式が異なります。また Apple は M3 Ultra での同種の数値を公表していないため、Ultra との比較はできません。桁の目安としてご覧ください。
長い資料を読ませる使い方なら、①の差は待ち時間としてそのまま出ます。短い指示で長文を書かせるなら、②の速い機材が効きます。どちらが速いかは、使い方を決めるまで決まりません。
①読み込みで、各チップを並べる
Apple は①読み込みについて、絶対値ではなく倍率を公表しています。いずれも LM Studio を使った Apple 自身の測定(2026年7月)です。
| チップ | 直前世代との比 | 同系 M1 との比 |
|---|---|---|
| M6(Mac mini) | M4 の 4.8倍 | M1 の 13.5倍 |
| M5 Max | M4 Max の 3.9倍 | M1 Max の 10.7倍 |
| M3 Ultra | 公表値なし | 約2.45倍(計算値) |
| M3 Max | 公表値なし | 公表値なし |
| DGX Spark | 倍率ではなく実測値を公表(10,256 tok/s ほか) | |
| RTX 5090 / RTX 4090 | ①の公表値なし(NVIDIA は DGX Spark のみ公開) | |
⚠ 「M1 との比」を横に並べて比べてはいけません。基準がそれぞれ M1・M1 Max・M1 Ultra と別の機械だからです。13.5 と 9.8 を見比べて「M6 のほうが M5 Ultra より速い」とはなりません。(基準が違うものを並べて比べても意味がない、という例です)
M3 Max の①は、Apple が公表していません。M3 Ultra も単体の値はなく、M5 世代との比較での基準として登場します。表の2.45倍は、9.8 ÷ 4 で出した計算値です。M3 Ultra で読み込みの実測があるのは、70B 4bit で 480 tok/s(本記事の近似逆算の基準)です。
海外実測でも同じ順位:3機種の読み込みを数字で比べる
読み込みは演算性能で決まる、という本記事の理論は、海外の実測データとも一致します。2026年に公開された複数の実測(MLX・llama.cpp・vLLM の各計測)を整理すると、3機種の実効演算能力は次のとおりです。
| 機種 | 根拠 | 実効演算能力(FP16換算) |
|---|---|---|
| RTX 5090 | NVIDIA 公表 3,352 TOPS(FP4) | 約1,676 TFLOPS |
| DGX Spark(GB10) | 8B の prefill 10,256 tok/s(NVIDIA 公表)を逆算 | 約164 TFLOPS |
| MacBook Pro M5 Max | Qwen 3.5 27B の prefill 686 tok/s 実測(MLX・Neural Accelerators 込み)を逆算 | 約37 TFLOPS |
倍率に直すと、GB10 は M5 Max の約4.4倍、RTX 5090 は GB10 の約10倍です。読み込み(①)では演算回路の大きさがそのまま順位になるため、帯域で勝る M5 Max でも、この順位には届きません。
この差は、長い資料を渡したときの待ち時間としてそのまま出ます。40,000語のプロンプトを渡したときの「最初の1語が出るまでの時間」の実測は次のとおりです。
| プロンプト長 | RTX 5090 | DGX Spark | MacBook Pro M5 Max |
|---|---|---|---|
| 8,000語 | 1.1秒 | 6.7秒 | 20秒 |
| 40,000語 | 5.6秒 | 33秒 | 100秒 |
| 128,000語 | 18秒 | 107秒 | 320秒 |
待ち時間の比は約5.6倍・約18倍で、実効演算能力の比とほぼ一致します。読み込みは演算律速、書く(②)は帯域律速——この2つの律速が入れ替わるため、M5 Max は帯域 614GB/s で書くほうでは GB10(273GB/s)に勝つのに、読むほうでは逆転して負ける、という現象が数字で説明できます。
なお M5 Max の Neural Accelerators は効果があり、MLX を使うと M4 Max 比で読み込みが大幅に改善します(実測で prefill が約4倍改善した報告あり)。それでも NVIDIA の Blackwell 世代には届きません。データセンター向けに設計された行列積回路と、GPU コアの中に組み込んだ小さな演算器では、回路の規模が違うためです。
※ 出典: theaibench.ai(MLX・llama.cpp 実測)、presenc.ai(Time-to-First-Token 実測 2026)、NVIDIA 公表値。計測ソフト・量子化方式によって数値は変わります。倍率は桁の目安としてお読みください。
実測から読み込みの演算性能を近似で出す
Apple が①の絶対値を公表していないなら、こちらで計算してしまえば済むはずです。読み込みは入力が長いと計算律速になるため、「読み込みの実測 tok/s × 1トークンの計算量」から、実効の演算性能を近似逆算できます。1トークンの計算量は「パラメータ数 × 2」という近似を使います(70B なら 140 GFLOP、FP16 換算)。
llama.cpp の llama-bench を同一条件(70B・Q4_K_M・512トークンのプロンプト)で回した公開実測(SpecPicks 等の集計、2026年5月)から出したのが次の表です。
| チップ | ① 読み込み実測(70B・pp512) | 実効計算力(FP16 換算) | FP4 換算の物差しに直すと |
|---|---|---|---|
| M3 Max 16コア | 約140 tok/s | 約20 TFLOPS | 約39 TOPS |
| M4 Max 16コア | 約210 tok/s | 約29 TFLOPS | 約59 TOPS |
| M3 Ultra 60コアGPU | 約340 tok/s | 約48 TFLOPS | 約95 TOPS |
| M3 Ultra 80コアGPU | 約480 tok/s | 約67 TFLOPS | 約134 TOPS |
| DGX Spark | 8B で 10,256 tok/s(公表値)から逆算 | 約164 TFLOPS | 約328 TOPS |
読み取れることは3つあります。
- 計算力そのものは DGX Spark が約2倍上です。Tensor Core と CUDA の本領はここに出ます
- ただし Spark は公表 1,000 TOPS のうち約3分の1しか実効に出ていません。カタログ TOPS は sparse と最適化が揃った最高条件の数字です。実用の LLM 処理ではこの効率が現れます
- それでも生成(②)は帯域律速で逆転します。同じ 320B モデルの生成で Spark は M3 Ultra の3分の1。計算力と実用速度が乖離するのが、この世代の読み方です
⚠ この逆算は ①トークンの計算量を「2×パラメータ数」と近似する ②実測の量子化(Q4_K_M)とソフト(llama.cpp/Metal)で測っている、という2つの仮定を含みます。ソフトの実装差で数値は大きく揺れるため、桁の目安としてお読みください。FP4 換算は FP16 の8倍という回路近似による換算で、Apple Silicon に FP4 専用回路はありません。
世代で伸びたのは、読み込みのほうでした
Ultra 系を世代でさかのぼると、意外な事実が出てきます。②は本記事の式による計算値、①は Apple の公表値です。
| 世代 | 帯域 | ② 生成(70B) | ① 読み込み(M1 Ultra 比) |
|---|---|---|---|
| M1 Ultra | 800GB/s | 約19.0 tok/s | 1倍 |
| M2 Ultra | 800GB/s | 約19.0 tok/s | 公表値なし |
| M3 Ultra | 819GB/s | 約19.5 tok/s | 約2.45倍(計算値) |
M1 から M3 まで、帯域はほぼ据え置きです。②は帯域で決まるため、70Bの生成速度だけなら M1 Ultra と M3 Ultra はほとんど変わりません。帯域が5割増しになるのは、次の M5 世代からです。
ところが①は違います。同じ4年で9.8倍。この期間に伸びたのは、書く速さではなく読む速さでした。
②だけを見れば、扱うモデルが70B前後で収まり中古の価格差が大きいなら、旧世代にも余地があります。ただし①を含めると、その判断は変わります。長い資料を読ませるなら、待ち時間が桁で違います。
古い Mac で、長い資料が極端に遅くなる理由
「Mac は AI が遅い」という評判を聞くことがあります。ここまでの2つを重ねると、その中身が説明できます。
1つ目は、資料の長さです。Apple の測定は4,096トークンでした。日本語ならおおよそ数千文字ぶんです。ここに8倍の資料を渡すと、総当たりの組み合わせは8×8で約64倍になります。
2つ目は、世代です。行列積を専門に扱う回路(Neural Accelerators)が GPU に載ったのは M5 世代からで、M3 Ultra はこれを持っていません。読み込み(①)はこの回路の有無で大きく変わります。Apple の公表値では M5 Ultra の①は M1 Ultra の9.8倍で、M3 Ultra は約2.45倍(計算値)にとどまります。
長い資料と、古い世代。この2つが重なると、待ち時間は分単位になります。評判の中身は、多くがここです。②の生成が遅いのではなく、①の読み込みで待たされていた、というのが実際のところです。
⚠ 具体的な秒数は、機種と資料の長さによって変わります。ここで示したのは、なぜ桁が変わりうるのかという理屈です。本記事では実測していません。
M5 世代で最も伸びたのが、この①でした。②の帯域は M3 Ultra 比で1.5倍ですが、①は4倍です(M3 Ultra を基準にした場合)。遅いと言われてきた部分が、いま最も大きく改善しています。
どのチップに、どのモデルが載るのか
「42GB」が何かを、はっきりさせておきます。AI が覚えた数字の集まり、つまりモデルの重みです。読ませる資料のことではありません。
70B というのは「700億個の数字を覚えている」という意味です。1個あたり約0.6バイトで持つので、掛け算すると約42GBになります。
| モデル | 覚えている数字の数 | 重み |
|---|---|---|
| 8B | 80億個 | 約5GB |
| 14B | 140億個 | 約8GB |
| 30B | 300億個 | 約18GB |
| 70B | 700億個 | 約42GB |
| 405B | 4,050億個 | 約243GB |
この荷物を置く場所がメモリ(倉庫)で、GPU へ運ぶ道が帯域(配管)です。倉庫と配管を、チップごとに並べます。
| チップ | 倉庫(最大メモリ) | 配管(帯域) | 70B は載るか | ② の速さ |
|---|---|---|---|---|
| M3 | 24GB | 100GB/s | 載りません | — |
| M3 Max(40コア) | 128GB | 400GB/s | 載ります | 約9.5 tok/s |
| M5 | 32GB | 153GB/s | 載りません | — |
| M6 | 32GB | 不明 | 載りません | 不明 |
| M5 Max(40コア) | 128GB | 614GB/s | 載ります | 約14.6 tok/s |
| DGX Spark(GB10) | 128GB | 273GB/s | 載ります | 約6.5 tok/s |
倉庫に入らなければ、速さの話は始まりません。M3・M5・M6 の基本モデルは70Bが載りません。24GBや32GBの倉庫に、42GBの荷物は置けないからです。
M6 の配管は「不明」としています。Mac mini の構成によって153GB/sと170GB/sの2種類があり、どちらになるかを見分ける方法が確認できていないためです。推測では書きません。
Apple は倉庫を、NVIDIA は配管を大きくしています
NVIDIA のデータセンター用 GPU「Rubin」と並べると、方向の違いがはっきりします。
倉庫は Mac のほうが大きいのです。M3 Ultra が最大512GB、Rubin が1基288GB。大きなモデルを置くだけなら、Mac が勝ちます。
ところが配管は、毎秒819GB と毎秒22,000GB。約27倍の差があります。②の速さは、約19.5 tok/s と約524 tok/s になります。
倉庫が大きいと、大きなモデルを置けます。配管が太いと、速く書けます。Apple と NVIDIA は、別々の場所を大きくしているわけです。
⚠ Rubin はデータセンター用で、机の上には置けません。価格も桁が違います。ここでは伸ばしている方向の違いを見るために並べています。
①と②が、別々のチップに分かれ始めました
NVIDIA は Rubin 世代で、性格の違う2種類の GPU を出しました。
| メモリ | 特徴 | |
|---|---|---|
| Rubin | 288GB の高いメモリ(HBM4) | 配管が毎秒22,000GB |
| Rubin CPX | 128GB の安いメモリ(GDDR7) | 計算が30ペタフロップス、総当たりが3倍速い |
CPX のほうは、高いメモリを使っていません。そのぶん計算を強くしています。NVIDIA はこれを「とても長い文章を読むための、新しい種類の GPU」と説明しています。
とても長い文章を読む。これは①のことです。そして「総当たりが3倍速い」というのは、図2 のマス目の仕事が3倍速いという意味です。
①が得意なチップと、②が得意なチップ。2つの仕事が、2つの部品に分かれ始めています。本記事で説明してきた区別が、そのまま設計に出てきたかたちです。
⚠ NVIDIA の発表文は「①は計算で決まる、②は帯域で決まる」とは書いていません。ここは本記事の読み方です。ただし①向きに計算を厚くして安いメモリを積み、②向きに高いメモリを積む、という作り分けになっています。
注意点
① 4台つないでも、4倍にはなりません
Apple は「4台構成で単体比 最大 3倍」と説明しています。台数は4倍でも、伸びは最大でも3倍。つまり効率は最良の場合で約75%、実際にはそれ以下になります。
なぜ台数どおりに伸びないのか。一因は配管の細さと考えられます。Thunderbolt 5 の120Gb/sは毎秒15GB相当で、本体のメモリ帯域819GB/sの約55分の1です。
⚠ ただしどれくらい影響するかは、分け方によって変わります。層ごとに分ける方式なら台数をまたぐ通信は少なく、層の中で分ける方式なら通信が増えます。「配管が細いから必ず律速する」とは言い切れません。確かなのは、Apple 自身が「4倍ではなく最大3倍」と言っていることだけです。
台数を増やす目的は、速度より容量と考えるのが自然です。単体に載らない大きさのモデルを、2TBのメモリプールに載せる。それが4台構成の意味です。報道によれば5台以上はリング接続になり、効率はさらに落ちるとされています。
② 512GB構成は、まだ選べません
出荷は10月下旬とされており、現時点では構成の選択自体ができません。裏を返せば、実機のレビューが出そろってから判断する時間があるとも言えます。
③ 「4.3倍」は演算性能の話です
この「4.3倍」は、次世代 M5 Ultra が M3 Ultra 比で公表しているピークAI演算性能の話であり、生成速度そのものではありません。帯域で比べると1,200÷819で約1.5倍です。この2つの数字は、別のものを測っています。本記事の基準機は M3 Ultra 512GB ですが、読み込み重視なら M5 世代の登場を待つ選択肢もあります。
④ 電力は強みですが、日本では条件が違います
Apple は4台構成が標準的な壁コンセント1つで動くと説明しています。ただしこれは米国の基準(120V/15A)での話です。日本の一般的な家庭用コンセントは100V/15Aで、上限が異なります。4台構成を検討する場合は、設置場所の電源容量を先に確認してください。
⑤ 読み込みは、2回目以降を省ける場合があります
最初の1トークンまでの時間は演算性能で決まるため、モデルが大きいほど待ち時間が伸びます。これを丸ごと減らす仕組みがあります。
プロンプトキャッシュと呼ばれるものです。前回と先頭が一致している部分は計算し直さず、結果を使い回します。同じ資料に繰り返し質問する使い方では、効果が大きくなります。
ただし効くのは、先頭が一文字も違わない場合だけです。指示の冒頭に日付を書くと、毎日変わるため使い回しが無効になります。変わらないものを先に置き、変わるものを後ろに回す形が有利です。
⑥ 生成速度の上限を、部分的に超える方法があります
本記事の式は、1トークンごとにモデル全体を読み直すことを前提にしています。この前提を崩す手法があります。
小さなモデルに候補をまとめて出させ、本体のモデルが一括で検証する方式です。投機的デコードと呼ばれます。読み直しの回数が減るため、帯域から計算した上限を上回る場合があります。
効果はモデルの組み合わせと入力内容によって変わります。常に速くなるものではありません。
⑦ 数値はソフトウェアによって変わります
本記事で引いた Apple の測定値は、MLX を使ったものです。同じ Mac でも、別のソフトウェアでは値が変わります。
とくに読み込み側は、実装による差が出やすい部分です。他の環境の数値と比べる場合は、測定に使ったソフトウェアを揃えてください。
⑧ 現時点で分かっていないこと
- 実機の測定値:発売前のため、生成速度の実測は確認できていません
- 実効メモリの比率:GPUが使える割合をAppleは公表していません。本記事の75%は仮定です
- 日本での価格:公式ストアの表示をご確認ください
- 長時間動かしたときの挙動:発熱による速度の変化は、実機が出るまで分かりません
不明な点は埋めずに、そのまま残しています。
買うか、借りるか
大きなモデルを動かす選択肢は、手元の機材だけではありません。クラウドのGPUを時間単位で借りる方法もあります。どちらが得かは、使う時間で決まります。
- 損益分岐(か月)= 本体価格 ÷(1か月の利用時間 × クラウドの時間単価)
たとえば月に数時間しか使わないなら、借りるほうが長く安く済みます。逆に毎日動かし続けるなら、買い切りのほうが早く元が取れます。時間単価は提供元ごとに大きく違うため、検討される方はご自身の使い方と、利用予定サービスの料金表を突き合わせてみてください。
手元に置く利点は費用だけではありません。データを外に出さずに済むこと、通信の遅延がないこと、使いたいときに待たないこと。ここは価格表に出てこない部分です。
よくある質問
Q. 512GBあれば、どんなモデルでも動きますか。
4bit量子化で約640Bまでが計算上の上限です。8bitにすると上限はおよそ半分以下になります。それを超えるものは、複数台をつなぐ構成が必要になります。
Q. RTX PRO 6000 のほうが理論速度が高いなら、そちらでは。
96GBを超えるモデルは載りません。400B級を1台で扱いたい場合は、選択肢から外れます。使うモデルの大きさが先で、速度はその次という順番になります。
Q. 数字はどこまで信用できますか。
本記事の数値は、各社が公表した帯域とメモリ容量から計算したものです。実測ではありません。実際の帯域は理論値の6〜8割に落ちるのが一般的で、下振れする前提でご覧ください。
Q. 256GB構成では足りませんか。
70B(4bit・42GB)までなら256GB構成で載ります。512GBが要るのは、320B級のFP8(重み328GB)や100万語の長文脈を扱う場合です。400B級を狙うなら512GB構成を選んでください。
Mac Studio M3 Ultra 512GB の特徴は、速度そのものよりも「512GBの容量と819GB/sの帯域を、1台で両立している」点にあります。個人が購入できる製品の範囲では、同じ条件を満たすものは当サイトの調べでは見あたりません(データセンター向けの製品は対象外としています)。一方、70B以下で足りるのであれば、より安い選択肢が複数あります。
実機の数値が出そろったら、本記事の計算と突き合わせて検証します。
Apple公式ストアで Mac Studio の最新価格を確認する
本記事はメーカー公式情報・販売ページ・公開されている情報の調査に基づいて作成しています。
結論:3機種の使い分け
テキスト生成(LLM)中心なら、Mac Studio M3 Ultra 512GB。帯域が太く、大モデルが載り、静音・省電力です。動画生成は遅いものの、テキストの生成・長文の読み込みでは3機種中もっとも実用的です。
イメージ生成・動画生成中心なら、RTX 5090。演算性能(FLOPS)が圧倒的に大きく、CG系のAIでは最速です。ただし大モデルのメモリ容量が足りず、電力も575WとPC全体の設計が必要です。
DGX Spark は、どちらかに振り切るなら中間です。メモリ128GBで70Bが載り、CUDA環境もある一方で、帯域が273GB/sと細いため生成速度は出ません。「1台で開発も試すこともしたい」場合に、両方の性質をある程度持つのが強みです。
両方を1台で回したい場合は、M3 Ultra と RTX 5090 PC の併用が理想ですが、コストは約320万円(M3 Ultra 512GB 約282万円+RTX 5090 PC 約35万円)に達します。予算に応じて、テキスト生成中心なら M3 Ultra、CG生成中心なら RTX 5090 PC、という使い分けが現実的な選択になります。
本記事の3機種(Amazon)
本記事で取り上げた機材です。価格と在庫は Amazon でご確認ください(Amazonアソシエイト・リンクにはアフィリエイトタグが含まれます)。
- Apple Mac Studio(M5 Maxチップ・18コアCPU/32コアGPU) — メモリ128GB/256GB/512GB は商品ページ内で選択できます
- NVIDIA DGX Spark(GB10・128GB LPDDR5X 統一メモリ) — NVIDIA純正版(PNY製)
- ZOTAC GAMING GeForce RTX 5090 SOLID OC(32GB GDDR7) — 搭載PCの構成は別途必要です

コメント